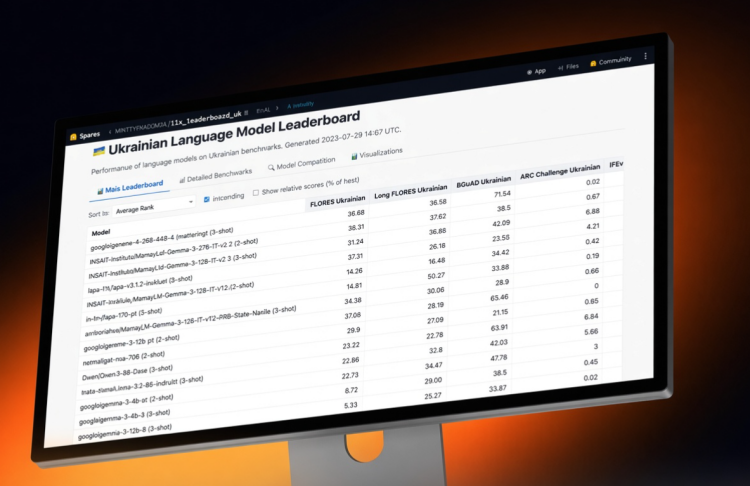
Міністерство цифрової трансформації спільно з Українським католицьким університетом та ініціативою lang-uk розпочали проект під назвою Ukrainian LLM Leaderboard. Це відкрита платформа, що призначена для оцінки великих мовних моделей, орієнтуючись на їх ефективність при роботі з українською мовою.
Як повідомляє пресслужба Мінцифри,
«Виникнення великих мовних моделей поставило питання про їх ефективність у контексті української мови: які їхні переваги та недоліки, для яких задач вони найкраще підходять, а де ще залишаються прогалини в якості обробки українського тексту. Створення українського лідерборду має на меті надати відповідь на ці питання, зібравши наявні бенчмарки від спільноти в галузі українського NLP та розробивши нові», — зазначив Юрій Панів, керівник проекту по розробці мовної моделі для української мови Lapa.
Тестування моделей охоплює ряд завдань, що можуть виникати під час їх практичного використання:
- переклад та адаптація текстів;
- пошук інформації в документах;
- логіка та розв'язування задач;
- завдання зі шкільної програми на рівні ЗНО;
- математичні задачі;
- виконання складних інструкцій.
Всі результати, код та дані тестування вже доступні на платформі Hugging Face, що дозволяє користувачам порівнювати моделі та ознайомлюватися з методами їх оцінювання.
У подальшому команда планує розширити рейтинг, включивши оцінки, пов'язані з роботою з зображеннями, етичними аспектами та вартості використання штучного інтелекту українською мовою.
Окрім того, планується перевірка моделей на виконання державних завдань, які стосуватимуться адміністративних процедур, нормативних документів та персональних даних.
Варто нагадати, що Державна архівна служба України надала близько 10 теребайт інформації для моделі (LLM) під назвою "Сяйво", що рівнозначно за обсягом текстів великий масив, еквівалентний приблизно 70 000 книжок.